Evaluación de 22 modelos de lenguaje en una computadora local antigua

Por: Julio Cesar Sandria Reynoso
Maestro en Inteligencia Artificial
15 de Octubre de 2026

¿Puede una computadora antigua convertirse en un servidor de inteligencia artificial? Evaluamos 22 modelos con Ollama.

Una experiencia del Instituto de Robótica de Xalapa (iRoX) para aprovechar computadoras existentes mediante inteligencia artificial local: Benchmark iRoX V0.8.7.

Introducción

La inteligencia artificial generativa suele asociarse con centros de datos y tarjetas gráficas de alto rendimiento. Sin embargo, también podemos aprovechar computadoras que han dejado de utilizarse y convertirlas en servidores locales de IA. En iRoX nos preguntamos qué tan útil puede ser una computadora antigua para ejecutar modelos de lenguaje con Ollama.

No buscamos competir con los grandes servicios comerciales, sino identificar modelos utilizables, comparar la calidad de sus respuestas y medir cuánto tardan en generarlas. El experimento terminó con 22 modelos evaluados, 220 respuestas históricas y dos candidatos recomendados para necesidades diferentes.

1. El origen del proyecto

En septiembre de 2026 documentamos en Robótica Sandria la instalación de una IA generativa con Ubuntu y Ollama. El equipo tenía originalmente 8 GB de RAM y un disco duro mecánico (HDD, hard disk drive). Después ampliamos la memoria a 32 GB y actualizamos el almacenamiento a una unidad de estado sólido (SSD, solid state drive) para probar modelos mayores.

ComponenteConfiguración durante el benchmark
ProcesadorIntel Pentium G4400, 3.30 GHz
RAM32 GB (2 × 16 GB)
Almacenamiento principalSSD de 120 GB
Tarjeta gráfica con GPUNVIDIA GTX 750 Ti, 2 GB
Sistema operativoUbuntu Server 24.04 LTS
MotorOllama
Inferencia principalCPU

La GPU (Graphics Processing Unit o Unidad de Procesamiento Gráfico) no se utilizó como acelerador principal. Una pregunta todavía pendiente es si los 32 GB de RAM eran necesarios para los modelos finalmente elegidos o si una ampliación menor habría bastado.

2. ¿Qué medimos?

Un benchmark es un conjunto de pruebas ejecutadas bajo condiciones definidas. En este estudio consideramos calidad de respuesta, tiempo medio por prueba, capacidad de ejecución y fiabilidad. La prioridad fue comparar la calidad y el tiempo total de respuesta en un mismo servidor. Estos resultados son una evaluación operativa, no una validación científica general de los modelos.

3. Evolución del benchmark iRoX

El proyecto comenzó con un cliente Python para comunicarse con Ollama. Se añadieron registros de tiempo, respuestas y métricas; un banco de diez pruebas; ejecución por lotes; exportación CSV; conservación de respuestas; evaluación automática; y auditorías de discrepancias. Las versiones V0.6 consolidaron el banco de pruebas y las series V0.7 y V0.8 profundizaron en la revisión de calidad y trazabilidad. Este artículo utiliza los resultados consolidados V0.8.7.

4. El banco de diez pruebas

IDÁrea
MAT-001Matemáticas
MAT-002Matemáticas
LOG-001Lógica
LOG-002Lógica
PROG-001Programación
PROG-002Programación
ROB-001Robótica
IA-001Inteligencia artificial
DAT-001Análisis de datos
STEM-001Ciencia, tecnología e ingeniería

Una actividad solicitaba analizar los tiempos 2, 3, 3, 4 y 8 segundos. La media correcta es 4 segundos y la mediana 3. También se evaluaron tareas de Python y situaciones de robótica, como el uso de sensores para seguir una línea. Cada uno de los 22 modelos recibió diez pruebas.

5. Los 22 modelos evaluados

La tabla muestra las puntuaciones consolidadas de iRoX V0.8.7, los tamaños registrados para los modelos y los tiempos medios por prueba. El tamaño del archivo del modelo no equivale a la RAM máxima consumida durante su ejecución.

PosiciónModeloTamañoCalidad /100Tiempo medio (s)
1gemma3:4b3.11 GB98.33166.39
2sam860/LFM2:700m754.91 MB93.3331.74
3gemma2:2b1.52 GB93.3340.75
4qwen2.5:1.5b940.38 MB88.3329.10
5sam860/olmo2:1b-Q5_K_M1.00 GB86.6740.79
6llama3.2:3b1.88 GB85.00105.86
7llama3.2:latest1.88 GB85.00116.40
8qwen2.5:3b1.80 GB80.00108.50
9granite4:3b1.96 GB80.00113.45
10llama3.2:1b1.23 GB71.6736.81
11phi3:latest2.03 GB68.3379.63
12jewelzufo/unsloth_granite-4.0-h-350m-GGUF:latest212.36 MB60.002.59
13qwen3:8b4.87 GB60.00493.59
14llama2-uncensored:latest3.56 GB57.5055.59
15tinyllama:latest608.16 MB45.0030.04
16hf.co/CoreWorxLab/caal-qwen3.5-2b:latest1.19 GB40.0059.25
17jewelzufo/MiniCPM5-1B:latest656.19 MB37.5067.48
18smollm:1.7b-instruct-v0.2-q2_K643.34 MB22.5090.49
19moondream:latest1.62 GB18.3312.57
20smollm2:135m-instruct-q4_K_M100.58 MB15.0020.74
21qwen3:4b2.33 GB10.00256.45
22Alieno/ailo-152m-v3:latest155.63 MB5.000.76

Fuente: resultados históricos consolidados de iRoX Benchmark V0.8.7. Los tiempos no están normalizados por número de tokens. Una puntuación baja puede reflejar fallos de formato, truncamiento o incompatibilidad de la tarea con el modelo; no demuestra inutilidad general.

6. Selección de los cinco finalistas

Para el análisis final seleccionamos los cinco modelos con mejores resultados de calidad en nuestro banco de pruebas, considerando también sus tiempos y tamaños.

ModeloTamaño del modeloCalidad /100Tiempo medio (s)
gemma3:4b3.11 GB98.33166.39
sam860/LFM2:700m754.91 MB93.3331.74
gemma2:2b1.52 GB93.3340.75
qwen2.5:1.5b940.38 MB88.3329.10
sam860/olmo2:1b-Q5_K_M1.00 GB86.6740.79

gemma3:4b obtuvo la puntuación más alta (98.33/100), con 166.39 segundos de promedio por prueba. sam860/LFM2:700malcanzó 93.33/100 y tardó 31.74 segundos en promedio: fue aproximadamente 5.24 veces más rápido en tiempo total por prueba. Esa razón no significa que genere tokens 5.24 veces más rápido, porque la longitud de las respuestas puede diferir.

7. El desafío de evaluar modelos con otros modelos

Para automatizar la revisión usamos, entre otros procedimientos, un modelo juez: granite3.3:2b. Descubrimos que un juez de IA también puede equivocarse. Por ejemplo, aprobó una función que utilizaba n % 1 == 0 para determinar si un número es par, aunque la condición correcta para enteros es n % 2 == 0. También aceptó una media de 4.2 para el conjunto de datos cuya media correcta era 4.

Esto confirmó la importancia de conservar las respuestas originales, verificar los resultados deterministas y revisar las discrepancias antes de modificar puntuaciones.

8. Auditoría final V0.8.7

Revisamos 33 casos de los cinco finalistas. Se detectaron siete discrepancias entre las puntuaciones históricas y las del juez. Tras contrastar evidencias, se aceptó una corrección y se conservaron seis puntuaciones históricas. La corrección afectó a sam860/LFM2:700m en ROB-001: de 100 a 66.67 puntos por una explicación insuficiente de la corrección de dirección del robot mediante sus motores. Su promedio global pasó de 96.67 a aproximadamente 93.33.

La auditoría no equivale a una revisión independiente exhaustiva de las 220 respuestas.

9. La decisión: dos modelos complementarios

Gemma 3 de 4 mil millones de parámetros: prioridad en calidad

Recomendamos gemma3:4b para explicaciones educativas, apoyo en programación y consultas técnicas en las que se tolere una respuesta más lenta.

LFM2 de 700 millones de parámetros: prioridad en rapidez

Recomendamos sam860/LFM2:700m para consultas breves, asistentes educativos sencillos e interacciones frecuentes. gemma2:2b permanece como alternativa de respaldo.

10. ¿Valió la pena ampliar la RAM de 8 a 32 GB?

La ampliación aportó capacidad para cargar modelos y trabajar con mayores contextos, pero todavía no podemos demostrar que toda esa memoria fuera indispensable para los modelos seleccionados. También cambiaron el almacenamiento y parte del entorno de software, de modo que no sería válido atribuir cualquier mejora solamente a la RAM. En inferencia sobre CPU importan el procesador, el ancho de banda de memoria, el tamaño del modelo y la configuración de ejecución.

11. Lo que aprendimos

Una computadora antigua puede ejecutar IA local, pero el modelo más grande no siempre es la mejor elección. La velocidad y la calidad deben medirse por separado; el tiempo total no sustituye a los tokens por segundo. Las evaluaciones automáticas necesitan verificaciones objetivas. Guardar respuestas, parámetros y resultados permite auditar sin repetir inferencias costosas. Finalmente, una inversión en hardware debe justificarse con mediciones comparables.

12. Próximo proyecto: iRoX-Bench Lite

Proponemos desarrollar iRoX-Bench Lite, una herramienta que ayude a estudiantes, docentes e instituciones a evaluar computadoras reutilizadas como servidores de IA. Queremos que en minutos u horas identifique modelos viables, memoria utilizada, velocidad, calidad aproximada y mejoras de hardware potencialmente justificadas.

El plan contempla un diagnóstico rápido de 15–30 minutos, una evaluación estándar de 60–120 minutos y pruebas ampliadas cuando sean necesarias. Son objetivos de diseño, no tiempos garantizados.

Conclusiones

Tras evaluar 22 modelos con 220 pruebas, encontramos dos opciones útiles para el servidor estudiado: gemma3:4b cuando importa la calidad y sam860/LFM2:700m cuando importa la rapidez. Más allá de estos resultados, el objetivo es crear un procedimiento sencillo que permita a otras personas evaluar equipos existentes antes de desecharlos o invertir en actualizaciones.

Antes de desechar una computadora, vale la pena investigar qué puede hacer con las herramientas actuales.

Referencias y recursos

  1. Sandria, J. C. (2026). Instalación de una IA generativa con Ubuntu y Ollama. Robótica Sandria.
  2. Instituto de Robótica de Xalapa (2026). Benchmark iRoX V0.8.7: resultados consolidados de 22 modelos. Documentación interna del proyecto.
  3. Ollama. Documentación oficial y API.
  4. ggml-org. llama.cpp.
  5. EleutherAI. Language Model Evaluation Harness.
  6. MLCommons. MLPerf Inference.
  7. Vaswani, A., et al. (2017). Attention Is All You Need. NeurIPS 30.
  8. ChatGTP. chatgpt.com.

Nota metodológica: Las puntuaciones corresponden a la evaluación operativa iRoX V0.8.7. Algunas calificaciones históricas no se han verificado exhaustivamente mediante revisión independiente. Los resultados describen el comportamiento observado en este servidor y no deben extrapolarse automáticamente a otros equipos o aplicaciones.
Crea tu servidor de Inteligencia Artificial con una computadora antigua

Por: Julio César Sandria Reynoso
Maestro en Inteligencia Artificial
6 de octubre de 2026

Guía Técnica para la configuración y puesta en marcha de un servidor de Inteligencia Artificial con Ubuntu Server, Ollama y NVIDIA en una computadora antigua.

Este documento detalla el proceso completo de configuración, instalación, optimización y prueba de un servidor de Inteligencia Artificial local desplegado sobre Ubuntu Server 24.04.5 LTS, aprovechando hardware dedicado e integración mediante API remota y scripts en Python.

1. Especificaciones del Hardware del Servidor

La computadora usada como servidor de inteligencia artificial en el Instituto de Robótica de Xalapa cuenta con el siguiente perfil técnico optimizado para cargas de trabajo locales:

ComponenteDetalle TécnicoEstado / Nota de rendimiento
Procesador (CPU)Intel(R) Pentium(R) CPU G4400 @ 3.30GHz (2 núcleos / 2 hilos, Skylake)Sin soporte para instrucciones AVX/AVX2. Operación orientada a gestión y soporte de RAM.
Memoria RAM32 GB DDR4 Synchronous 2667 MHz (2 módulos de 16 GB)Excelente capacidad para almacenar modelos de lenguaje de tamaño intermedio.
Tarjeta Gráfica (GPU)NVIDIA GeForce GTX 750 Ti (Arquitectura Maxwell, GM107, 2 GB VRAM)Controlador propietario instalado con éxito. Soporte funcional para operaciones base de CUDA.
AlmacenamientoSSD ADATA SP580 (120 GB) + Disco mecánico adicional de 500 GBEspacio suficiente para sistema operativo, dependencias y almacenamiento de modelos LLM.
RedRealtek PCI Express Gigabit EthernetConectividad estable para servicio local de IA y peticiones en red.

Cabe mencionar que el equipo usado fue ampliado con memoria RAM y la reinstalación de la tarjeta gráfica que tuvo años atrás y que no se usó al preparar el artículo precedente: Instalación de una IA Generativa con Ubuntu y Ollama.

2. Configuración del Entorno Gráfico y Controladores NVIDIA

Para habilitar el soporte de hardware en la tarjeta gráfica NVIDIA GTX 750 Ti, se superaron incidencias iniciales de comunicación con el kernel mediante una purga limpia e instalación del controlador estable.

Resultado Exitoso: Al ejecutar el comando nvidia-smi, el sistema reportó correctamente la versión de controlador 580.178.04 y CUDA 13.0 vinculada a la GeForce GTX 750 Ti.

# Purgar instalaciones previas conflictivas
sudo apt purge nvidia* -y
sudo apt autoremove -y

# Instalar el controlador propietario estable
sudo apt install nvidia-driver-535 -y
sudo reboot

3. Instalación y Configuración del Servicio Ollama

Ollama fue instalado y configurado como un demonio del sistema mediante systemd para garantizar su ejecución automática en segundo plano y su disponibilidad ante reinicios.

# Descarga e instalación automatizada de Ollama
curl -fsSL https://ollama.com/install.sh | sh

# Ejecutar ollama con modelo qwen2.5:1.5b. /exit para salir
ollama run qwen2.5:1.5b
>>> Escribe una historia corta sobre un robot curioso
>>> /exit

# Creación del archivo de servicio systemd (/etc/systemd/system/ollama.service)
[Unit]
Description=Ollama Service
After=network-online.target

[Service]
ExecStart=/usr/local/bin/ollama serve
User=ollama
Group=ollama
Restart=always
RestartSec=3
Environment="PATH=$PATH"

[Install]
WantedBy=default.target

4. Exposición de la API en la Red Local

Para permitir que otros equipos de la red local se comuniquen con el servidor de IA, se configuró la variable de entorno OLLAMA_HOST modificando el servicio systemd:

sudo systemctl edit ollama.service

# Contenido de la anulación (override.conf):
[Service]
Environment="OLLAMA_HOST=0.0.0.0:11434"

# Recargar y reiniciar el servicio
sudo systemctl daemon-reload
sudo systemctl restart ollama

5. Desarrollo de Clientes y Ejemplos de Programación en Python

Se configuró un entorno de desarrollo en la computadora cliente (macOS) utilizando entornos virtuales (venv) y la librería oficial ollama para consumir el modelo qwen2.5:1.5b desplegado en el servidor.

Programa 1: Respuesta en Streaming en Tiempo Real

import ollama

client = ollama.Client(host='http://192.168.1.50:11434')

stream = client.chat(
    model='qwen2.5:1.5b',
    messages=[
        {
            'role': 'user',
            'content': 'Escribe una historia corta sobre un robot curioso.',
        },
    ],
    stream=True,
)

print('IA: ', end='', flush=True)
for chunk in stream:
    print(chunk['message']['content'], end='', flush=True)

print()

Programa 2: Uso de Prompt de Sistema (Roles)

import ollama

client = ollama.Client(host='http://192.168.1.50:11434')

stream = client.chat(
    model='qwen2.5:1.5b',
    messages=[
        {
            'role': 'system',
            'content': 'Eres un profesor experto en robótica industrial. Responde siempre de forma técnica, concisa y orientada a la enseñanza.',
        },
        {
            'role': 'user',
            'content': 'Explícame brevemente qué es la cinemática directa.',
        },
    ],
    stream=True,
)

print('IA: ', end='', flush=True)
for chunk in stream:
    print(chunk['message']['content'], end='', flush=True)

print()

Programa 3: Chat Continuo con Historial y Streaming

import ollama

client = ollama.Client(host='http://192.168.1.50:11434')

mensajes = [
    {
        'role': 'system',
        'content': 'Eres un profesor experto en robótica industrial y optimización. Responde de forma técnica y concisa.'
    }
]

print("Iniciando chat continuo con Ollama. Escribe 'salir' para terminar.\n")

while True:
    texto_usuario = input("Tú: ")
    if texto_usuario.lower() in ['salir', 'exit', 'quit']:
        break

    mensajes.append({'role': 'user', 'content': texto_usuario})

    stream = client.chat(
        model='qwen2.5:1.5b',
        messages=mensajes,
        stream=True
    )

    print("IA: ", end='', flush=True)
    respuesta_completa = ""

    for chunk in stream:
        contenido = chunk['message']['content']
        print(contenido, end='', flush=True)
        respuesta_completa += contenido

    print("\n")
    mensajes.append({'role': 'assistant', 'content': respuesta_completa})

6. Monitoreo Avanzado y Análisis Comparativo del Sistema con btop

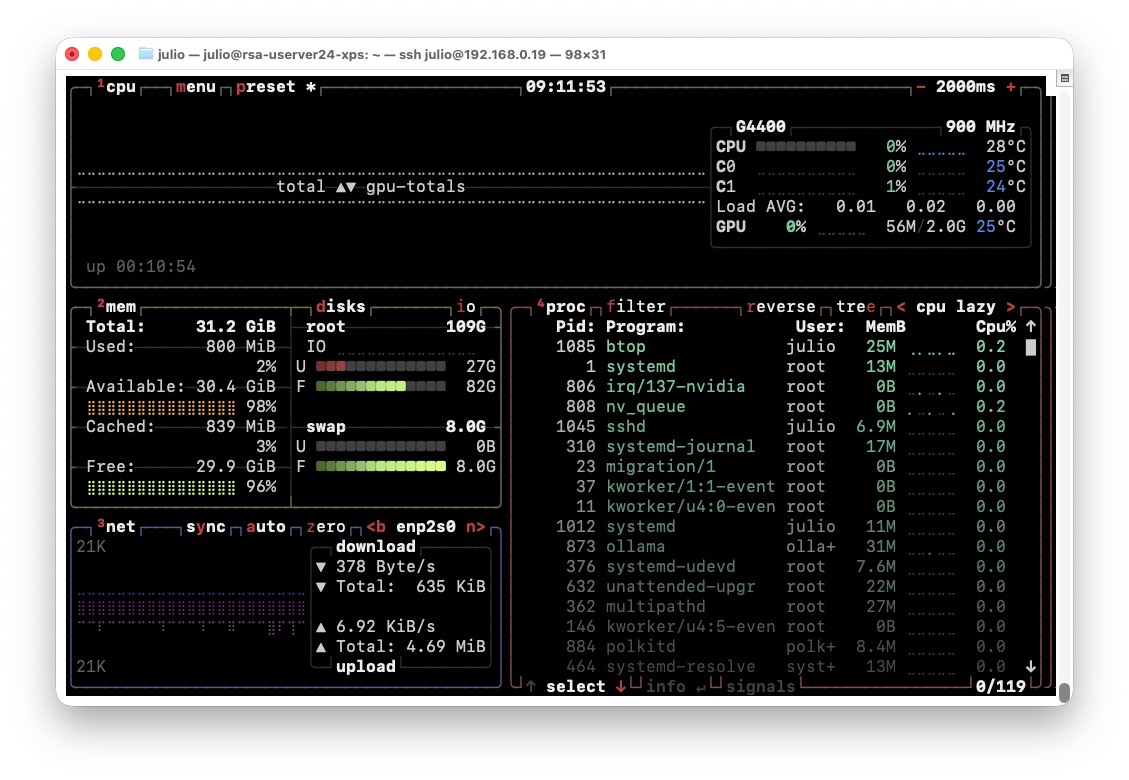
Para garantizar la estabilidad y comprobar la correcta distribución de la carga de trabajo entre la CPU, la RAM y la tarjeta gráfica, se utilizó la herramienta btop. A continuación se detalla el comportamiento del servidor bajo dos escenarios distintos de operación.

Instalación de btop en Ubuntu Server

# Actualizar repositorios e instalar btop
sudo apt update
sudo apt install btop -y

# Ejecutar el monitor
btop

Análisis Escenario A: Servidor en Reposo o con Peticiones Ligeras

Durante la operación normal o al recibir peticiones estándar de chat, el modelo qwen2.5:1.5b permanece residente en la memoria RAM (ocupando aproximadamente 1.3 GiB de forma estable en el proceso llama-server). El uso de la CPU se mantiene bajo y la tarjeta gráfica registra un uso mínimo.

Imagen 1: Captura de btop mostrando el servidor en estado de reposo, baja carga con llama-server usando ~1.3 GB de RAM y CPU en reposo

Análisis Escenario B: Servidor bajo Carga Masiva (Procesamiento de Textos Extensos)

Para comprobar la respuesta del servidor bajo una carga pesada, se ejecutó un script en el equipo cliente que envía un bloque de texto masivo para calcular la matriz de atención y el contexto (*KV Cache*).

Programa de Prueba con Bloque de Texto Extenso

import ollama

client = ollama.Client(host='http://192.168.1.50:11434')

# Creamos un bloque de texto grande para forzar el uso de memoria de contexto
bloque_texto = (
    "La robótica móvil autónoma y los sistemas de optimización combinatoria "
    "requieren algoritmos eficientes de navegación y búsqueda de rutas como A* "
    "y Dijkstra, integrando mapeo SLAM y sensores LiDAR en entornos dinámicos. "
) * 150

print("Enviando documento extenso al servidor de IA...")

stream = client.chat(
    model='qwen2.5:1.5b',
    messages=[
        {
            'role': 'system',
            'content': 'Eres un asistente técnico analítico. Resume y extrae los conceptos principales del texto proporcionado.'
        },
        {
            'role': 'user',
            'content': f'Por favor, analiza a detalle el siguiente documento:\n\n{bloque_texto}'
        }
    ],
    stream=True
)

print("IA: ", end='', flush=True)
for chunk in stream:
    print(chunk['message']['content'], end='', flush=True)

print("\n\nProceso finalizado.")

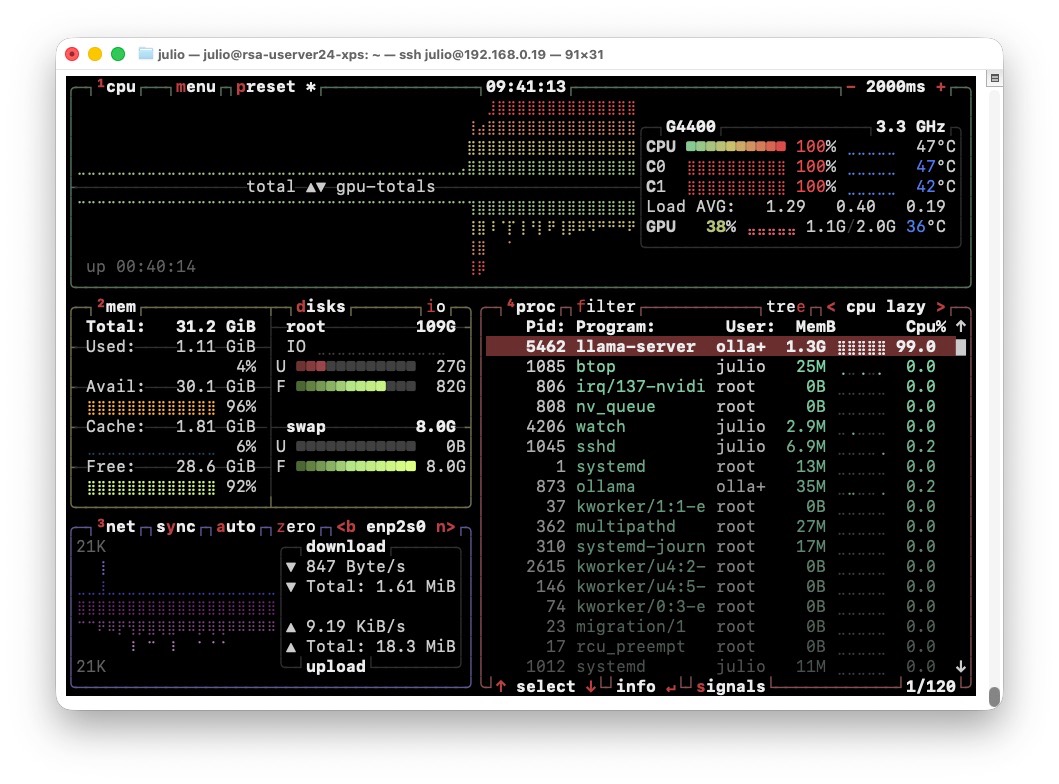
Al ejecutar este script, el comportamiento de los recursos en btop cambia drásticamente:

  • Uso del CPU al 100% (C0 y C1): Los dos núcleos del Intel Pentium G4400 se saturan por completo realizando los cálculos secuenciales del modelo.
  • Proceso Activo (llama-server): El consumo de CPU del proceso asciende al 99.0%, absorbiendo toda la capacidad de procesamiento disponible.
  • Actividad Gráfica (GPU): El uso de la GPU se incrementa (alrededor del 38%), mientras que la ocupación de la VRAM se mantiene en 1.1 GiB / 2.0 GiB, apoyando parcialmente en el procesamiento.
  • Temperatura: La temperatura de la CPU experimenta un incremento controlado (por ejemplo, a 47 °C), manteniéndose en un rango totalmente seguro.
Imagen 2: Captura de btop mostrando el servidor bajo carga masiva con CPU al 100%, proceso llama-server al 99% de CPU y GPU activa

7. Preguntas Frecuentes y Análisis de Arquitectura (Hardware y Rendimiento)

Pregunta: ¿Valió la pena ampliarle la RAM a la computadora de 8GB a 32GB si en reposo modelos ligeros como qwen2.5:1.5b apenas consumen 1.3 GB? ¿Y qué hay de la tarjeta gráfica GTX 750 Ti que se consideraba tecnología antigua?

Respuesta Técnica: Sí, ampliar la RAM a 32 GB y conservar la GTX 750 Ti fue una excelente decisión de arquitectura por los siguientes motivos:

  • Escalabilidad de Modelos: Aunque un modelo de 1.5B parámetros es ligero, modelos de mayor tamaño (como 7B u 8B) requieren entre 4.5 GB y 5.5 GB solo para cargar sus pesos. Con 8 GB totales, el sistema operativo (Ubuntu Server) se quedaría sin margen y generaría errores críticos por falta de memoria o paginación en disco (*Swap*). Con 32 GB hay total holgura.
  • Gestión del KV Cache y Contextos Largos: Al procesar documentos masivos, código fuente extenso o historiales de chat kilométricos, la memoria temporal para la matriz de atención (*KV Cache*) crece de manera importante, la cual es absorbida sin problemas por la RAM.
  • El Rol Real de la GTX 750 Ti: Aunque sus 2 GB de VRAM limitan la capacidad de alojar modelos completos (lo que obliga a delegar el cálculo pesado a la CPU al 100%), la tarjeta gráfica no está de adorno. Funciona como un coprocesador acelerador (registrando picos de uso del 38% bajo carga) para resolver operaciones matriciales específicas, además de gestionar la salida gráfica de forma independiente sin consumir la valiosa RAM del sistema.

8. Estrategia de Acceso Multiusuario y Herramientas Cliente en Red Local

Pregunta: Ya tenemos este servidor en un entorno escolar y daremos acceso a entre 2 y 5 colaboradores máximo. ¿Qué herramientas podemos instalar en las computadoras para que accedan al servidor y utilicen la IA configurada para analizar archivos y correr comandos de forma automatizada?

Respuesta Técnica: Para un grupo reducido de 2 a 5 usuarios concurrentes conectados al servidor Ollama (http://192.168.1.50:11434), existen excelentes alternativas dependiendo del flujo de trabajo:

  • Open WebUI (Interfaz tipo ChatGPT centralizada): Se despliega fácilmente mediante Docker en el servidor Ubuntu. Permite crear cuentas individuales para cada colaborador con historiales privados, soporte para carga y análisis de archivos (PDFs, documentos, código) mediante RAG, y acceso directo desde el navegador web de cada computadora (ej. http://192.168.1.50:3000) sin requerir hardware pesado local.
  • AnythingLLM (Especializado en bases documentales): Excelente para indexar directorios completos de archivos institucionales o académicos y consultar información de forma privada y estructurada.
  • Continue.dev (Para automatización de código y comandos): Extensión de código abierto para editores como VS Code que permite a los colaboradores modificar código, explicar scripts y generar comandos de terminal directamente desde su entorno de desarrollo, utilizando la potencia del servidor central.

9. Referencias Bibliográficas y Documentación Técnica

  • Ollama Documentation & API Guides: Documentación oficial sobre la API REST y configuración de red. Disponible en: Ollama FAQ & Configuration Guide.
  • Open WebUI Project Guide: Guía de despliegue mediante contenedores y gestión multiusuario. Disponible en: Open WebUI Documentation.
  • Continue.dev Open-Source Assistant: Documentación técnica sobre asistentes de código y editores locales. Disponible en: Continue Docs.
  • NVIDIA Driver & CUDA Documentation: Guías de controladores y plataforma de computación acelerada. Disponible en: NVIDIA CUDA Platform.

10. Conclusiones y Validación

El servidor rsa-userver24-xps se encuentra completamente operativo. La arquitectura implementada permite:

  • Ejecutar modelos de lenguaje eficientes como qwen2.5:1.5b utilizando los recursos optimizados del servidor.
  • Monitorear y comparar el rendimiento del hardware bajo distintas cargas mediante btop y nvidia-smi.
  • Atender peticiones descentralizadas desde múltiples equipos de la red local mediante la API REST y scripts avanzados en Python con streaming, roles, historial y pruebas de rendimiento.
  • Escalar el acceso a múltiples colaboradores mediante interfaces web y herramientas de asistencia técnica e integración documental.

Uso de pantalla 2.8″ TFT ILI9341 con Arduino Nano

Radar iRoX

Por: Julio Cesar Sandria Reynoso, David Rojas Bosada y Fernando Méndez Reyes
4 de octubre de 2026

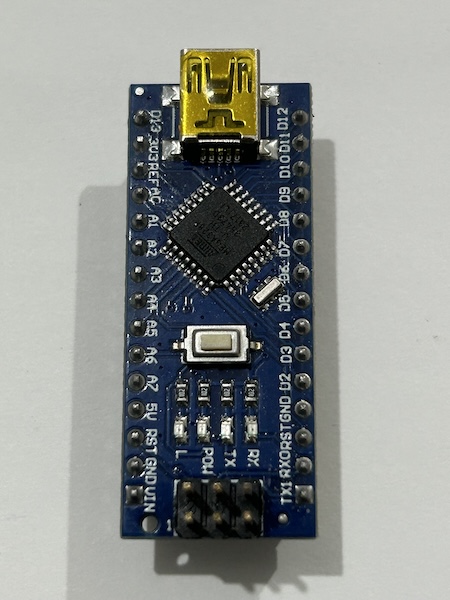
Arduino Nano Genérico

Desde hace unos meses, nuestro alumno del Instituto de Robótica de Xalapa (iRoX), David, nos trajo el reto de hacer funcionar unas pantallas de 2.8 pulgadas TFT con chip ILI9341 para su proyecto del robot BB8. Nuestro alumno Fernando, llevó a cabo las primeras investigaciones, la hizo funcionar y le proporcionó a David el esquema para hacer una placa PCB muy sencilla. En las últimas semanas, llegamos al punto de ya requerir instalar las pantallas en la unidad BB8 y retomamos el tema de las pantallas.

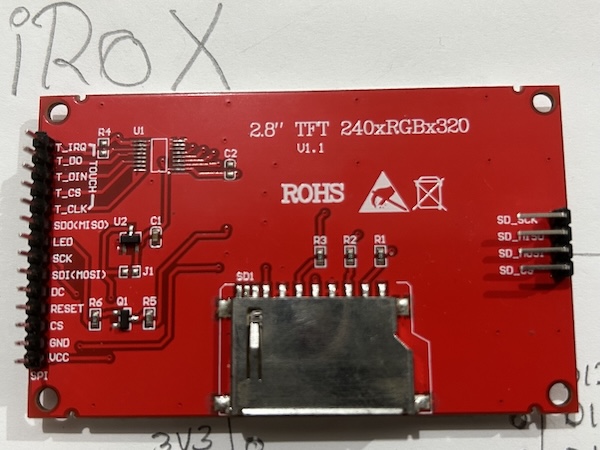
En este artículo publicamos lo necesario para replicar el inicio del uso de la pantalla 2.8″ TFT 240xRGBx320 V1.1 con circuito integrado ILI9341 en PCB roja, con Arduino Nano (genérico) programado en Arduino IDE 2.3.10.

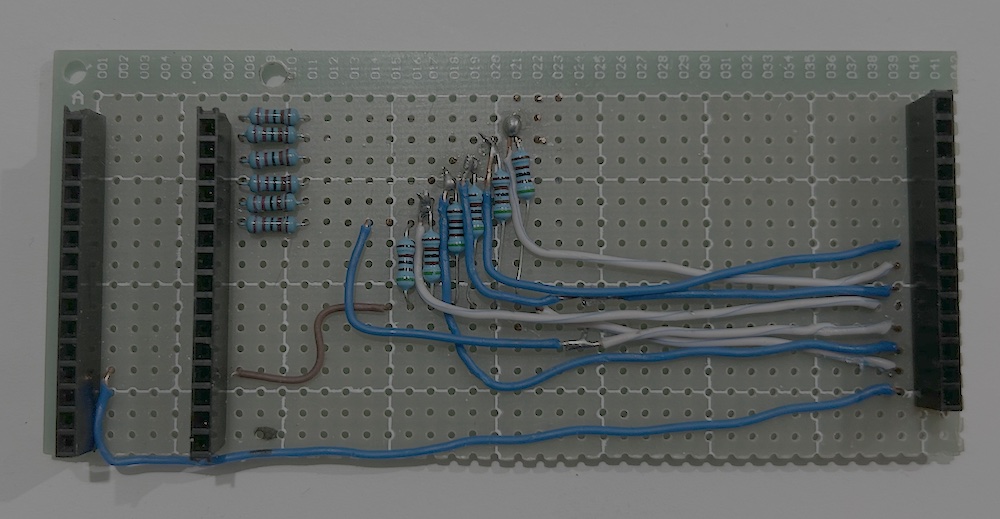
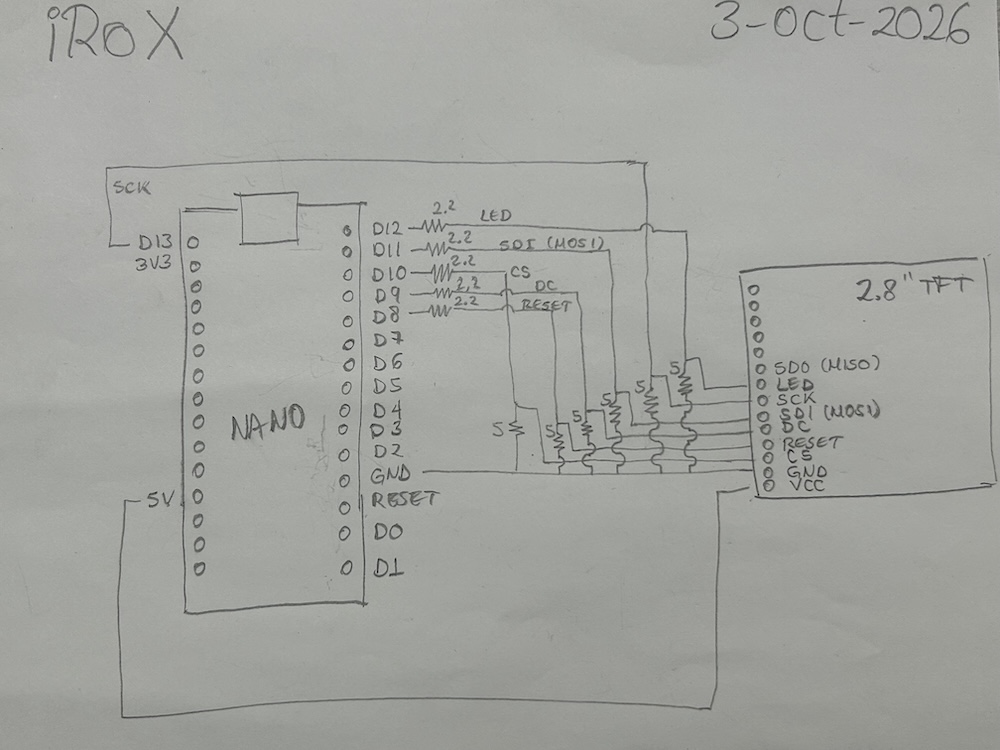
En una placa de prototipos PCB se soldaron los componentes para colocar Arduino Nano y la Pantalla 2.8 TFT, haciendo las divisiones de voltaje de 5V a 3.3V con resistencias de 2.5 y 5 Kohms.

Como se menciona al principio, empezamos a trabajar con esta pantalla algunos meses atrás (4 ó 5), por lo que al retomar el proyecto, usando la placa PCB ya soldada, y colocándole el Arduino Nano y la pantalla, los ejemplos de código en C++ en Arduino IDE que sabíamos que ya habían funcionado, pues no funcionaban. Dado que ya no teníamos a la mano el diagrama original, rehicimos el esquema electrónico para analizar bien las conexiones entre Arduino Nano y la Pantalla.

NOTA: Para probar los programas de ejemplo de Adafruit hay que instalar en Arduino IDE las librerías Adafruit ILI9341 y Adafruit GFX.

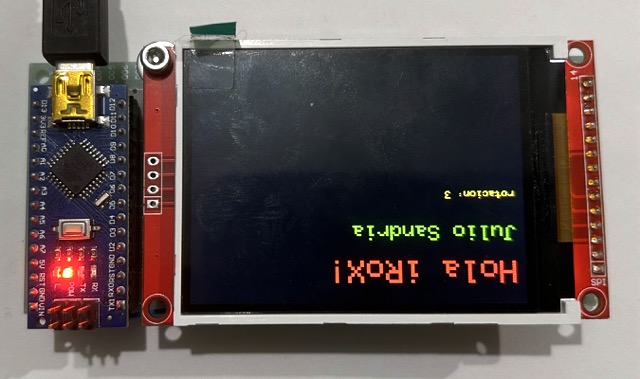
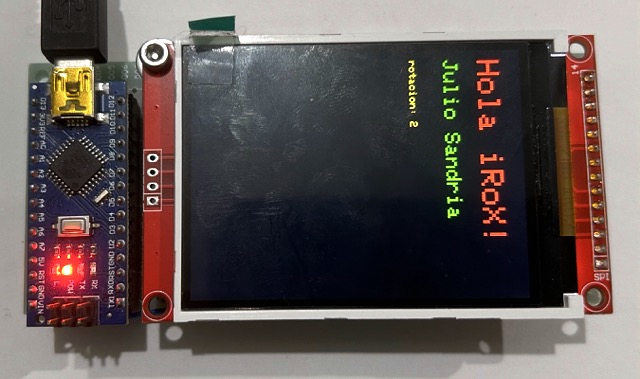
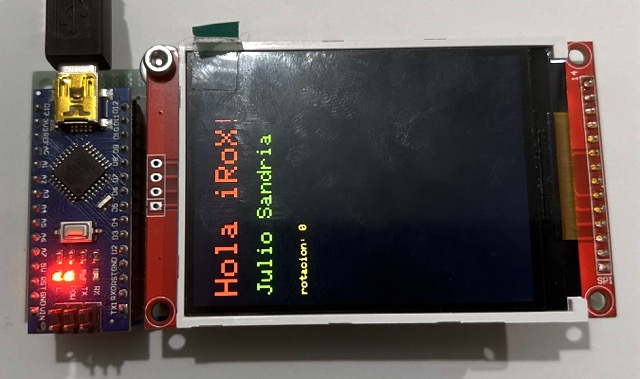
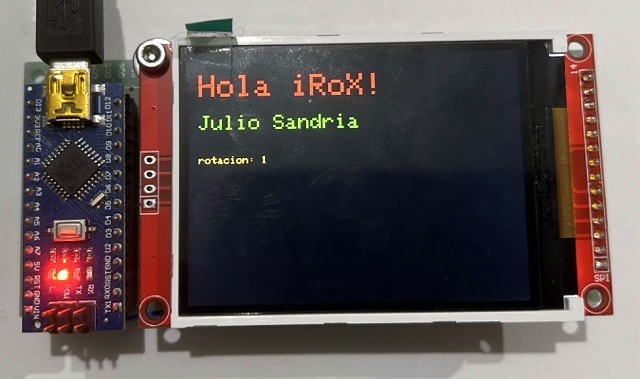
Una vez analizado cómo se había soldado la placa PCB y algunos ejemplos de programas disponibles de Adafruit para una pantalla 2.8 TFT con chip ILI9341, llegamos al siguiente programa para mostrar un «Hola iRoX» en la pantalla.

/*
Instituto de Robótica de Xalapa - 4-Octubre-2026
Programa: Pantalla-2.8-TFT_Hola_iRoX.ino (C++)
Basado en: Simple "Hello World" for ILI9341 LCD
https://wokwi.com/arduino/projects/308024602434470466
y complementado con ejemplos de Adafruit ILI9341
Autor: Julio César Sandria Reynoso
Colaboradores: David Rojas Bosada, Fernando Méndez Reyes
Hardware:
+ Pantalla 2.8" TFT 240xRGBx320 V1.1 (PCB Roja) chip ILI9341
+ Arduino NANO
+ PCB propio con divisores de voltaje de 5V a 3.3V
*/

#include "SPI.h"
#include "Adafruit_GFX.h"
#include "Adafruit_ILI9341.h"

// Asegura las siguientes conexiones al Arduino NANO:
// Pines 8 a 13 con divisores de voltaje de 5V a 3.3V
// NOTA: las macros (#define) tienen los nombres de pin
// de la pantalla y pueden variar respecto a los
// ejemplo originales de ADAFRUIT.
// PIN TFT VCC 5V Arduino
// PIN TFT GND GND Arduino
#define TFT_RESET 8
#define TFT_DC 9
#define TFT_CS 10
#define TFT_SDI 11
#define TFT_LED 12
#define TFT_SCK 13
Adafruit_ILI9341 tft = Adafruit_ILI9341(
TFT_CS, TFT_DC, TFT_SDI, TFT_SCK, TFT_RESET, TFT_LED);

void setup() {
tft.begin();
}

void loop(void) {
for(uint8_t rotacion=0; rotacion<4; rotacion++) {
tft.setRotation(rotacion);
texto(rotacion);
delay(1000);
}
}

void texto(uint8_t rotacion) {
tft.fillScreen(ILI9341_BLACK);
tft.setCursor(10, 20);
tft.setTextColor(ILI9341_RED);
tft.setTextSize(3);
tft.println("Hola iRoX!");

tft.setCursor(10, 60);
tft.setTextColor(ILI9341_GREEN);
tft.setTextSize(2);
tft.println("Julio Sandria");

tft.setCursor(10, 100);
tft.setTextColor(ILI9341_YELLOW);
tft.setTextSize(1);
tft.print("rotacion: ");
tft.println(rotacion);
}

Este programa ejecuta un ciclo for(…) dentro de la función loop(), imprimiendo el texto de la función texto(…) en cuatro orientaciones de la pantalla, que seguimos llamando rotaciones para conservar la terminología que usa la librería Adafruit ILI9341, con el método setRotation() del objeto tft.

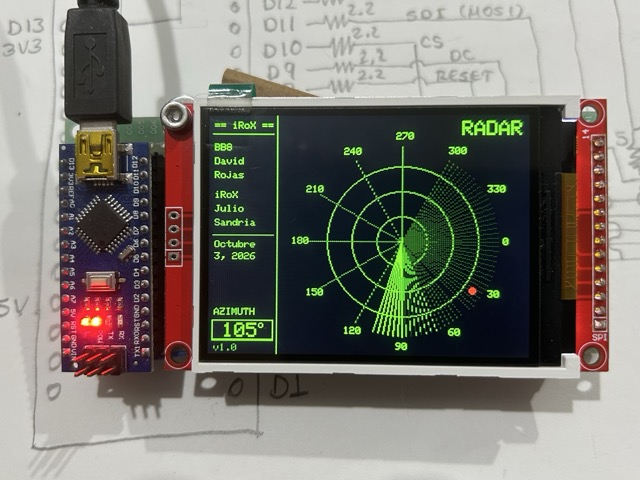
Y ya habiendo dominado las conexiones y algunos programas ejemplos de Adafruit ILI9341, nos pusimos a jugar un rato haciendo programas con ayuda de una inteligencia artificial generativa, cargando el programa al Arduino Nano y obteniendo algunas imágenes como la siguiente:

El programa funciona como un radar simulando que detecta objetos y mostrándolos como círculos rojos. A continuación está el programa que trabajamos Deepseek, David Rojas y Julio Sandria.

/*
  Instituto de Robótica de Xalapa - 4-Octubre-2026
  Programa: BB8_pant-2.8_radar_horizontal.ino (C++)
  Desarrollado por Julio César Sandria Reynoso, David Rojas Bosada y DeepSeek.
  Basado en: Pantalla-2.8-TFT_Hola_iRoX.ino

  Hardware:
  + Pantalla 2.8" TFT 240xRGBx320 V1.1 (PCB Roja) chip ILI9341
  + Arduino NANO
  + PCB propio con divisores de voltaje de 5V a 3.3V
*/

#include "SPI.h"
#include "Adafruit_GFX.h"
#include "Adafruit_ILI9341.h"

// Asegura las siguientes conexiones al Arduino NANO:
// Pines 8 a 13 con divisores de voltaje de 5V a 3.3V
// NOTA: las macros (#define) tienen los nombres de pin
//       de la pantalla y pueden variar respecto a los
//       ejemplo originales de ADAFRUIT.
// PIN TFT VCC    5V Arduino
// PIN TFT GND    GND  Arduino
#define TFT_RESET 8
#define TFT_DC    9
#define TFT_CS   10
#define TFT_SDI  11
#define TFT_LED  12
#define TFT_SCK  13
Adafruit_ILI9341 tft = Adafruit_ILI9341(
  TFT_CS, TFT_DC, TFT_SDI, TFT_SCK, TFT_RESET, TFT_LED);

// ---- Colores ----
#define RADAR_BG      0x0000   // Negro
#define RADAR_GRID    0x0320   // Verde oscuro
#define RADAR_RING    0x0640   // Verde medio
#define RADAR_TEXT    0x07E0   // Verde brillante
#define RADAR_BLIP    0xF800   // Rojo
#define RADAR_BLIP2   0xFFE0   // Amarillo
#define PANEL_BG      0x0000   // Fondo del panel
#define PANEL_LINE    0x0640   // Línea separadora (verde)
#define PANEL_WHITE   0xFFFF   // Blanco
#define HUD_COLOR     0x07E0   // Verde brillante para el HUD

// ---- Layout horizontal (320x240) ----
const int16_t SCREEN_W = 320;
const int16_t SCREEN_H = 240;

const int16_t PANEL_W  = 70;
const int16_t RADAR_AREA_X0 = PANEL_W;
const int16_t RADAR_AREA_W  = SCREEN_W - PANEL_W;  // 250 px

// Centro del radar dentro del área disponible
const int16_t CX = RADAR_AREA_X0 + RADAR_AREA_W / 2;  // ≈195
const int16_t CY = SCREEN_H / 2 + 6;                  // ≈126
const int16_t R  = 95;

// ---- Barrido ----
int16_t angle = 0;
const int16_t SWEEP_STEP = 3;
const int16_t TRAIL = 20;

// ---- Objetivos ----
struct Target {
  int16_t angle;
  int16_t dist;
  uint16_t color;
};

Target targets[] = {
  {  35,  85, RADAR_BLIP  },
  { 120,  55, RADAR_BLIP2 },
  { 200,  70, RADAR_BLIP  },
  { 275,  40, RADAR_BLIP2 },
  { 320,  90, RADAR_BLIP  },
};
const uint8_t NUM_TARGETS = sizeof(targets) / sizeof(targets[0]);
int16_t targetLastHit[NUM_TARGETS];

// ---- HUD ----
int16_t lastHudAngle = -1;   // Para no redibujar si no cambia

// ============================================================
// Utilidades
// ============================================================
float deg2rad(int16_t deg) { return deg * PI / 180.0; }

int16_t polarX(int16_t deg, int16_t radius) {
  return CX + (int16_t)(cos(deg2rad(deg)) * radius);
}
int16_t polarY(int16_t deg, int16_t radius) {
  return CY + (int16_t)(sin(deg2rad(deg)) * radius);
}

// Devuelve el ancho en píxeles de una cadena con el tamaño de texto actual.
// Útil para alinear a la derecha sin depender del font.
int16_t textWidthPx(const char* s, uint8_t size) {
  return strlen(s) * 6 * size;  // fuente estándar Adafruit: 6x8 px por carácter
}

// ============================================================
// Panel lateral izquierdo
// ============================================================
void drawSidePanel() {
  // Fondo del panel
  tft.fillRect(0, 0, PANEL_W, SCREEN_H, PANEL_BG);

  // Línea separadora vertical
  tft.drawFastVLine(PANEL_W - 1, 0, SCREEN_H, PANEL_LINE);

  // Encabezado
  tft.setTextSize(1);
  tft.setTextColor(RADAR_TEXT);
  tft.setCursor(6, 6);
  tft.print("== iRoX ==");

  tft.drawFastHLine(4, 18, PANEL_W - 8, PANEL_LINE);

  // Etiquetas con línea en blanco entre "Rojas" e "iRoX"
  struct Row { const char* text; uint16_t color; uint8_t gap; };
  Row rows[] = {
    { "BB8",     RADAR_TEXT, 0 },
    { "David",   RADAR_TEXT, 0 },
    { "Rojas",   RADAR_TEXT, 6 },   // <-- espacio extra (línea en blanco) después
    { "iRoX",    RADAR_TEXT, 0 },
    { "Julio",   RADAR_TEXT, 0 },
    { "Sandria", RADAR_TEXT, 0 },
  };
  const uint8_t n = sizeof(rows) / sizeof(rows[0]);

  int16_t y = 28;
  for (uint8_t i = 0; i < n; i++) {
    tft.setTextColor(rows[i].color);
    tft.setTextSize(1);
    tft.setCursor(6, y);
    tft.print(rows[i].text);
    y += 14 + rows[i].gap;
  }

  // ---- Después de "Sandria": línea separadora + fecha ----
  y += 2;                                     // pequeño respiro
  tft.drawFastHLine(4, y, PANEL_W - 8, PANEL_LINE);
  y += 6;

  tft.setTextColor(RADAR_TEXT);
  tft.setTextSize(1);
  tft.setCursor(6, y);
  tft.print("Octubre");
  y += 12;

  tft.setCursor(6, y);
  tft.print("3, 2026");

  // Pie del panel
  tft.drawFastHLine(4, SCREEN_H - 14, PANEL_W - 8, PANEL_LINE);
  tft.setTextColor(RADAR_GRID);
  tft.setCursor(6, SCREEN_H - 10);
  tft.print("v1.0");
}

// ============================================================
// HUD: indicador de ángulo dentro del panel
// ============================================================
void drawHudFrame() {
  // Etiqueta "AZ" y línea base; el valor lo actualiza updateHudAngle()
  tft.setTextSize(1);
  tft.setTextColor(HUD_COLOR);

  // Zona del HUD (parte baja del panel, encima del pie)
  int16_t yHud = SCREEN_H - 46;

  // Título del HUD
  tft.setCursor(6, yHud);
  tft.print("AZIMUTH");

  // Caja del valor
  tft.drawRect(4, yHud + 12, PANEL_W - 8, 20, HUD_COLOR);
}

void updateHudAngle(int16_t a) {
  if (a == lastHudAngle) return;
  lastHudAngle = a;

  int16_t yHud = SCREEN_H - 46;
  int16_t boxX = 4;
  int16_t boxY = yHud + 12;
  int16_t boxW = PANEL_W - 8;
  int16_t boxH = 20;

  // Borra el interior de la caja
  tft.fillRect(boxX + 1, boxY + 1, boxW - 2, boxH - 2, PANEL_BG);

  // Formatea "137" + símbolo de grado. El símbolo ° se dibuja como un pequeño círculo
  char buf[8];
  snprintf(buf, sizeof(buf), "%3d", a);

  tft.setTextSize(2);
  tft.setTextColor(HUD_COLOR);

  // Centrar el número dentro de la caja
  int16_t numW = textWidthPx(buf, 2);
  int16_t tx = boxX + (boxW - numW) / 2 - 2;  // -2 para dejar sitio al símbolo °
  int16_t ty = boxY + (boxH - 16) / 2 + 1;

  tft.setCursor(tx, ty);
  tft.print(buf);

  // Dibujar el símbolo de grado como un pequeño círculo
  int16_t degX = tx + numW + 2;
  int16_t degY = ty + 2;
  tft.drawCircle(degX, degY, 2, HUD_COLOR);
}

// ============================================================
// Fondo estático del radar
// ============================================================
void drawRadarBackground() {
  // Borra solo el área del radar
  tft.fillRect(RADAR_AREA_X0, 0, RADAR_AREA_W, SCREEN_H, RADAR_BG);

  // Círculos concéntricos
  for (int r = 25; r <= R; r += 25) {
    tft.drawCircle(CX, CY, r, RADAR_RING);
  }

  // Líneas radiales cada 30°
  for (int a = 0; a < 360; a += 30) {
    tft.drawLine(CX, CY, polarX(a, R), polarY(a, R), RADAR_GRID);
  }

  // Etiquetas de grados cada 30°
  tft.setTextSize(1);
  tft.setTextColor(RADAR_TEXT);
  for (int a = 0; a < 360; a += 30) {
    int16_t x = polarX(a, R + 10);
    int16_t y = polarY(a, R + 10);
    char buf[5];
    snprintf(buf, sizeof(buf), "%d", a);
    tft.setCursor(x - 6, y - 4);
    tft.print(buf);
  }

  // Cruz central
  tft.drawFastHLine(CX - 4, CY, 8, RADAR_TEXT);
  tft.drawFastVLine(CX, CY - 4, 8, RADAR_TEXT);

  // Título "RADAR" alineado a la DERECHA del área del radar
  tft.setTextSize(2);
  tft.setTextColor(RADAR_TEXT);
  const char* title = "RADAR";
  int16_t titleW = textWidthPx(title, 2);
  int16_t titleX = SCREEN_W - titleW - 6;   // 6 px de margen derecho
  int16_t titleY = 6;
  tft.setCursor(titleX, titleY);
  tft.print(title);
}

// ============================================================
// Barrido
// ============================================================
void drawSweep(int16_t currentAngle) {
  tft.drawLine(CX, CY, polarX(currentAngle, R), polarY(currentAngle, R), RADAR_TEXT);

  for (int i = 1; i <= TRAIL; i++) {
    int16_t a = currentAngle - i * SWEEP_STEP;
    if (a < 0) a += 360;

    uint16_t c;
    if      (i < TRAIL / 3)     c = 0x07E0;
    else if (i < 2 * TRAIL / 3) c = 0x03E0;
    else                        c = 0x01A0;

    tft.drawLine(CX, CY, polarX(a, R), polarY(a, R), c);
  }
}

void eraseSweep(int16_t currentAngle) {
  int16_t a = currentAngle - TRAIL * SWEEP_STEP;
  if (a < 0) a += 360;
  tft.drawLine(CX, CY, polarX(a, R), polarY(a, R), RADAR_BG);
  redrawOverlayAtAngle(a);
}

void redrawOverlayAtAngle(int16_t deg) {
  for (int r = 25; r <= R; r += 25) {
    tft.drawPixel(polarX(deg, r), polarY(deg, r), RADAR_RING);
  }
  for (int a = 0; a < 360; a += 30) {
    int16_t diff = abs(deg - a);
    if (diff < 3 || diff > 357) {
      tft.drawLine(CX, CY, polarX(a, 25), polarY(a, 25), RADAR_GRID);
      break;
    }
  }
}

// ============================================================
// Blips
// ============================================================
void drawBlips() {
  for (uint8_t i = 0; i < NUM_TARGETS; i++) {
    int16_t deg = targets[i].angle;
    int16_t r   = targets[i].dist;
    int16_t x   = polarX(deg, r);
    int16_t y   = polarY(deg, r);

    int16_t diff = abs(angle - deg);
    if (diff > 180) diff = 360 - diff;
    if (diff < SWEEP_STEP * 2) targetLastHit[i] = angle;

    if (targetLastHit[i] >= 0) {
      int16_t age = angle - targetLastHit[i];
      if (age < 0) age += 360;

      if (age < 60) {
        tft.fillCircle(x, y, 3, targets[i].color);
      } else if (age < 120) {
        tft.drawCircle(x, y, 3, targets[i].color);
      } else {
        tft.fillCircle(x, y, 3, RADAR_BG);
        for (int rr = 25; rr <= R; rr += 25) {
          if (abs(r - rr) < 3) tft.drawPixel(x, y, RADAR_RING);
        }
        targetLastHit[i] = -1;
      }
    }
  }
}

// ============================================================
// Setup / Loop
// ============================================================
void setup() {
  Serial.begin(9600);
  Serial.println("Radar ILI9341 horizontal iniciando...");

  tft.begin();
  tft.setRotation(1);   // 1 = apaisado (320x240)

  drawSidePanel();
  drawHudFrame();
  drawRadarBackground();
  updateHudAngle(0);

  for (uint8_t i = 0; i < NUM_TARGETS; i++) targetLastHit[i] = -1;

  Serial.println("Radar listo.");
}

void loop() {
  eraseSweep(angle);
  drawSweep(angle);
  drawBlips();
  updateHudAngle(angle);

  angle += SWEEP_STEP;
  if (angle >= 360) angle -= 360;

  delay(20);
}

Si tienes un proyecto por hacer con Lego Mindstorms, Arduino, Esp32, Raspberry Pi, Jetson Nano o necesitas ayuda con la programación en C/C++, Python, Java, JavaScript, o con el uso de herramientas de inteligencia artificial, no dudes en contactarnos en el Instituto de Robótica de Xalapa a través del sitio web www.irox.mx.