Actualización de servidor local de inteligencia artificial con tarjeta aceleradora de 16 GB

Por: Julio César Sandria Reynoso
Maestro en Inteligencia Artificial — Instituto de Robótica de Xalapa (iRoX)
Fecha de publicación: 5 de noviembre de 2026


En nuestro artículo anterior documentamos la puesta en marcha de un servidor local de Inteligencia Artificial utilizando hardware reutilizado con una tarjeta NVIDIA GTX 750 Ti de 2 GB y Ubuntu Server. Si bien el sistema demostró la viabilidad de ejecutar modelos ligeros de lenguaje (LLM) como qwen2.5:1.5b, el equipo aún requería una mayor capacidad de procesamiento para abordar cargas de trabajo más complejas.

Como primer paso en esta evolución, el pasado 20 de octubre actualizamos la arquitectura base del servidor incorporando un procesador Intel Core i7-6700 @ 3.40 GHz (4 núcleos / 8 hilos), duplicando la capacidad de cómputo multihilo del procesador previo. Posteriormente, para elevar radicalmente las capacidades de inferencia, realizamos una actualización crítica en la aceleración gráfica: la integración de una tarjeta NVIDIA Tesla P100 de 16 GB de VRAM HBM2, acompañada de una fuente de poder de 850 W y un circuito de refrigeración adaptado con control inteligente por software desde la tarjeta madre.

A continuación, detallamos la arquitectura actualizada del servidor rsa-userver24-xps-1, el procedimiento de configuración del ventilador por PWM en Ubuntu Server 24.04.5 LTS y el análisis de los nuevos modelos de lenguaje recomendados para este clúster.


1. Especificaciones Actualizadas del Hardware del Servidor

El servidor rsa-userver24-xps-1 cuenta actualmente con la siguiente configuración de alto rendimiento:

Componente / ParámetroDetalle Técnico ActualizadoImpacto en el Rendimiento
Sistema Operativo / KernelUbuntu 24.04.5 LTS (Kernel 6.8.0-147-generic)Entorno estable de 64 bits optimizado para servicios demonizados.
Procesador (CPU)Intel Core i7-6700 @ 3.40 GHz (4 núcleos / 8 hilos)Actualizado el 20/oct: Alta capacidad multihilo para gestionar la red, el bus PCIe y peticiones concurrentes.
Memoria RAM32 GB total DDR4Holgura total para buffers de contexto extensos y estabilidad del sistema.
Acelerador (GPU)NVIDIA Tesla P100 PCIe (16 GB VRAM HBM2)Salto masivo: Capacidad para alojar modelos de 7B, 8B y 14B 100% en GPU.
Placa MadreGigabyte GA-H110M-DS2 (Socket LGA1151)Gestión de sensores Super I/O mediante el chip ITE IT8628.
Fuente de PoderBalam Rush GR BURST GR850G (850 W)Suministro eléctrico estable con conectores dedicados PCIe de 8 pines.
AlmacenamientoSSD 500 GB + Disco HDD 500 GBEspacio amplio para el sistema operativo y repositorio de múltiples LLMs.
Servicio OllamaOllama 0.40.5 en puerto TCP 11434 (escuchando en *:11434)API REST disponible para toda la red local del iRoX.

2. Innovación en Refrigeración: Control Automático del Ventilador PWM por Software

La NVIDIA Tesla P100 es una tarjeta diseñada originalmente para servidores en rack con enfriamiento pasivo. Al instalarla en una computadora de escritorio con un conector adaptado y un ventilador dedicado, surgió el reto de regular su velocidad de giro según el calentamiento real del procesador gráfico.

Dado que la tarjeta madre Gigabyte GA-H110M-DS2 cuenta únicamente con dos conectores (CPU_FAN y SYS_FAN), desconectamos el ventilador de extracción de aire del gabinete que estaba conectado al puerto SYS_FAN y lo conectamos directo a un conector de 12 V de la Fuente de poder. Esto nos permitió conectar el ventilador de la P100 al puerto SYS_FAN y desarrollamos un puente por software mediante un script en Python ejecutado como servicio del sistema (systemd).

A. Carga del Controlador Super I/O de la Tarjeta Madre

El kernel de Ubuntu reconoce el chip supervisor de la placa base mediante el módulo it87. Para habilitar la lectura de sensores y el control PWM (Modulación por Ancho de Pulsos):

# Cargar el módulo del chip ITE IT8628
sudo modprobe it87

# Asegurar que el módulo se cargue en cada inicio del sistema
echo "it87" | sudo tee -a /etc/modules

Al ejecutar el comando sensors, el sistema expone los puertos de ventilador bajo el dispositivo hwmon2 (chip it8628-isa-0a40).

B. Script de Control Termodinámico en Python (/usr/local/bin/gpu_fan_control.py)

Este programa consulta en tiempo real la temperatura de la GPU vía nvidia-smi y ajusta dinámicamente el ciclo de trabajo del ventilador (valores de 0 a 255 en /sys/class/hwmon/hwmon2/pwm1):

#!/usr/bin/env python3
import time
import subprocess
import os

# Rutas de control PWM en la placa madre Gigabyte (hwmon2)
PWM_PATH = "/sys/class/hwmon/hwmon2/pwm1"
PWM_ENABLE_PATH = "/sys/class/hwmon/hwmon2/pwm1_enable"

def configurar_modo_manual():
    """Establece el puerto SYS_FAN en modo de control por software."""
    try:
        if os.path.exists(PWM_ENABLE_PATH):
            with open(PWM_ENABLE_PATH, 'w') as f:
                f.write('1')
    except Exception:
        pass

def obtener_temperatura_gpu():
    try:
        resultado = subprocess.run(
            ["nvidia-smi", "--query-gpu=temperature.gpu", "--format=csv,noheader"],
            capture_output=True, text=True, check=True
        )
        return int(resultado.stdout.strip())
    except Exception:
        return 50  # Valor de seguridad por defecto

def calcular_pwm(temp):
    """
    Curva de velocidad según la temperatura:
    - Temp <= 40 °C: 30% velocidad (~76)
    - Temp 40 °C - 75 °C: Escala lineal progresiva (30% a 100%)
    - Temp >= 75 °C: 100% velocidad (255)
    """
    if temp <= 40:
        return 76
    elif temp >= 75:
        return 255
    else:
        return int(76 + (temp - 40) * (255 - 76) / (75 - 40))

def main():
    configurar_modo_manual()
    while True:
        temp = obtener_temperatura_gpu()
        pwm_valor = calcular_pwm(temp)
        try:
            with open(PWM_PATH, 'w') as f:
                f.write(str(pwm_valor))
        except Exception:
            pass
        time.sleep(5)

if __name__ == "__main__":
    main()

C. Creación del Daemon en Systemd (/etc/systemd/system/gpu-fan.service)

Para automatizar la ejecución permanente en segundo plano:

[Unit]
Description=Control Automatizado de Ventilador para NVIDIA Tesla P100
After=multi-user.target

[Service]
ExecStart=/usr/local/bin/gpu_fan_control.py
Restart=always
RestartSec=10

[Install]
WantedBy=multi-user.target

Activación del servicio:

sudo systemctl daemon-reload
sudo systemctl enable --now gpu-fan.service

3. Modelos de Lenguaje (LLMs) Sugeridos para la Tesla P100

Con los 16 GB de VRAM HBM2 (con un ancho de banda superior a los 720 GB/s) y el procesador Intel Core i7-6700 respaldando la ejecución, los siguientes modelos se alojan completamente en la GPU, ofreciendo respuestas instantáneas y soporte para múltiples usuarios concurrentes:

  • Qwen 2.5 (7B / 14B):
    ollama run qwen2.5:7b (4.7 GB VRAM)
    ollama run qwen2.5:14b (9.0 GB VRAM)
    Excelente razonamiento lógico, capacidades multilenguaje avanzadas y alto desempeño en generación de código Python.
  • DeepSeek-R1 Distill Qwen (7B / 14B):
    ollama run deepseek-r1:7b
    ollama run deepseek-r1:14b
    Especializados en razonamiento complejo (cadena de pensamiento / thinking) para matemáticas y algoritmos.
  • Llama 3.1 (8B):
    ollama run llama3.1 (4.7 GB VRAM)
    El estándar abierto de Meta para tareas generales, redacción y agentes de asistencia.
  • Gemma 2 (9B):
    ollama run gemma2 (5.4 GB VRAM)
    Modelo altamente optimizado de Google con excelente precisión en análisis conceptual.

4. Ventajas de la Nueva Configuración

  1. Procesamiento Balanceado (i7-6700 + Tesla P100): El procesador de 4 núcleos y 8 hilos elimina cualquier latencia en el manejo del sistema operativo y los sockets de red, permitiendo que la GPU Tesla P100 se dedique en un 100% a la inferencia matricial.
  2. Inferencia Ultra-Rápida: Al caber los modelos completos en los 16 GB de VRAM, los cálculos son ejecutados por los 3584 núcleos CUDA, logrando altas velocidades de generación de tokens.
  3. Seguridad Termodinámica Automática: El script en Python regula las RPM del ventilador en función de la temperatura reportada por la GPU, manteniendo el chip en rangos seguros.
  4. Sostenibilidad Institucional: Se mantiene la filosofía del Instituto de Robótica de Xalapa: reutilizar y repotenciar infraestructura existente para poner inteligencia artificial avanzada al alcance de la comunidad académica.

5. Conclusión

El servidor rsa-userver24-xps-1 del Instituto de Robótica de Xalapa se consolida como un verdadero nodo local de Inteligencia Artificial de alto rendimiento. La combinación de Ubuntu Server 24.04.5 LTS, Ollama 0.40.5, el procesador Intel Core i7-6700 y la aceleración de la NVIDIA Tesla P100 demuestra el enorme potencial del software libre y la optimización de hardware en entornos educativos.

Este documento fue hecho con ayuda de Google Gemini.
Evaluación de 22 modelos de lenguaje en una computadora local antigua

Por: Julio Cesar Sandria Reynoso
Maestro en Inteligencia Artificial
15 de Octubre de 2026

¿Puede una computadora antigua convertirse en un servidor de inteligencia artificial? Evaluamos 22 modelos con Ollama.

Una experiencia del Instituto de Robótica de Xalapa (iRoX) para aprovechar computadoras existentes mediante inteligencia artificial local: Benchmark iRoX V0.8.7.

Introducción

La inteligencia artificial generativa suele asociarse con centros de datos y tarjetas gráficas de alto rendimiento. Sin embargo, también podemos aprovechar computadoras que han dejado de utilizarse y convertirlas en servidores locales de IA. En iRoX nos preguntamos qué tan útil puede ser una computadora antigua para ejecutar modelos de lenguaje con Ollama.

No buscamos competir con los grandes servicios comerciales, sino identificar modelos utilizables, comparar la calidad de sus respuestas y medir cuánto tardan en generarlas. El experimento terminó con 22 modelos evaluados, 220 respuestas históricas y dos candidatos recomendados para necesidades diferentes.

1. El origen del proyecto

En septiembre de 2026 documentamos en Robótica Sandria la instalación de una IA generativa con Ubuntu y Ollama. El equipo tenía originalmente 8 GB de RAM y un disco duro mecánico (HDD, hard disk drive). Después ampliamos la memoria a 32 GB y actualizamos el almacenamiento a una unidad de estado sólido (SSD, solid state drive) para probar modelos mayores.

ComponenteConfiguración durante el benchmark
ProcesadorIntel Pentium G4400, 3.30 GHz
RAM32 GB (2 × 16 GB)
Almacenamiento principalSSD de 120 GB
Tarjeta gráfica con GPUNVIDIA GTX 750 Ti, 2 GB
Sistema operativoUbuntu Server 24.04 LTS
MotorOllama
Inferencia principalCPU

La GPU (Graphics Processing Unit o Unidad de Procesamiento Gráfico) no se utilizó como acelerador principal. Una pregunta todavía pendiente es si los 32 GB de RAM eran necesarios para los modelos finalmente elegidos o si una ampliación menor habría bastado.

2. ¿Qué medimos?

Un benchmark es un conjunto de pruebas ejecutadas bajo condiciones definidas. En este estudio consideramos calidad de respuesta, tiempo medio por prueba, capacidad de ejecución y fiabilidad. La prioridad fue comparar la calidad y el tiempo total de respuesta en un mismo servidor. Estos resultados son una evaluación operativa, no una validación científica general de los modelos.

3. Evolución del benchmark iRoX

El proyecto comenzó con un cliente Python para comunicarse con Ollama. Se añadieron registros de tiempo, respuestas y métricas; un banco de diez pruebas; ejecución por lotes; exportación CSV; conservación de respuestas; evaluación automática; y auditorías de discrepancias. Las versiones V0.6 consolidaron el banco de pruebas y las series V0.7 y V0.8 profundizaron en la revisión de calidad y trazabilidad. Este artículo utiliza los resultados consolidados V0.8.7.

4. El banco de diez pruebas

IDÁrea
MAT-001Matemáticas
MAT-002Matemáticas
LOG-001Lógica
LOG-002Lógica
PROG-001Programación
PROG-002Programación
ROB-001Robótica
IA-001Inteligencia artificial
DAT-001Análisis de datos
STEM-001Ciencia, tecnología e ingeniería

Una actividad solicitaba analizar los tiempos 2, 3, 3, 4 y 8 segundos. La media correcta es 4 segundos y la mediana 3. También se evaluaron tareas de Python y situaciones de robótica, como el uso de sensores para seguir una línea. Cada uno de los 22 modelos recibió diez pruebas.

5. Los 22 modelos evaluados

La tabla muestra las puntuaciones consolidadas de iRoX V0.8.7, los tamaños registrados para los modelos y los tiempos medios por prueba. El tamaño del archivo del modelo no equivale a la RAM máxima consumida durante su ejecución.

PosiciónModeloTamañoCalidad /100Tiempo medio (s)
1gemma3:4b3.11 GB98.33166.39
2sam860/LFM2:700m754.91 MB93.3331.74
3gemma2:2b1.52 GB93.3340.75
4qwen2.5:1.5b940.38 MB88.3329.10
5sam860/olmo2:1b-Q5_K_M1.00 GB86.6740.79
6llama3.2:3b1.88 GB85.00105.86
7llama3.2:latest1.88 GB85.00116.40
8qwen2.5:3b1.80 GB80.00108.50
9granite4:3b1.96 GB80.00113.45
10llama3.2:1b1.23 GB71.6736.81
11phi3:latest2.03 GB68.3379.63
12jewelzufo/unsloth_granite-4.0-h-350m-GGUF:latest212.36 MB60.002.59
13qwen3:8b4.87 GB60.00493.59
14llama2-uncensored:latest3.56 GB57.5055.59
15tinyllama:latest608.16 MB45.0030.04
16hf.co/CoreWorxLab/caal-qwen3.5-2b:latest1.19 GB40.0059.25
17jewelzufo/MiniCPM5-1B:latest656.19 MB37.5067.48
18smollm:1.7b-instruct-v0.2-q2_K643.34 MB22.5090.49
19moondream:latest1.62 GB18.3312.57
20smollm2:135m-instruct-q4_K_M100.58 MB15.0020.74
21qwen3:4b2.33 GB10.00256.45
22Alieno/ailo-152m-v3:latest155.63 MB5.000.76

Fuente: resultados históricos consolidados de iRoX Benchmark V0.8.7. Los tiempos no están normalizados por número de tokens. Una puntuación baja puede reflejar fallos de formato, truncamiento o incompatibilidad de la tarea con el modelo; no demuestra inutilidad general.

6. Selección de los cinco finalistas

Para el análisis final seleccionamos los cinco modelos con mejores resultados de calidad en nuestro banco de pruebas, considerando también sus tiempos y tamaños.

ModeloTamaño del modeloCalidad /100Tiempo medio (s)
gemma3:4b3.11 GB98.33166.39
sam860/LFM2:700m754.91 MB93.3331.74
gemma2:2b1.52 GB93.3340.75
qwen2.5:1.5b940.38 MB88.3329.10
sam860/olmo2:1b-Q5_K_M1.00 GB86.6740.79

gemma3:4b obtuvo la puntuación más alta (98.33/100), con 166.39 segundos de promedio por prueba. sam860/LFM2:700malcanzó 93.33/100 y tardó 31.74 segundos en promedio: fue aproximadamente 5.24 veces más rápido en tiempo total por prueba. Esa razón no significa que genere tokens 5.24 veces más rápido, porque la longitud de las respuestas puede diferir.

7. El desafío de evaluar modelos con otros modelos

Para automatizar la revisión usamos, entre otros procedimientos, un modelo juez: granite3.3:2b. Descubrimos que un juez de IA también puede equivocarse. Por ejemplo, aprobó una función que utilizaba n % 1 == 0 para determinar si un número es par, aunque la condición correcta para enteros es n % 2 == 0. También aceptó una media de 4.2 para el conjunto de datos cuya media correcta era 4.

Esto confirmó la importancia de conservar las respuestas originales, verificar los resultados deterministas y revisar las discrepancias antes de modificar puntuaciones.

8. Auditoría final V0.8.7

Revisamos 33 casos de los cinco finalistas. Se detectaron siete discrepancias entre las puntuaciones históricas y las del juez. Tras contrastar evidencias, se aceptó una corrección y se conservaron seis puntuaciones históricas. La corrección afectó a sam860/LFM2:700m en ROB-001: de 100 a 66.67 puntos por una explicación insuficiente de la corrección de dirección del robot mediante sus motores. Su promedio global pasó de 96.67 a aproximadamente 93.33.

La auditoría no equivale a una revisión independiente exhaustiva de las 220 respuestas.

9. La decisión: dos modelos complementarios

Gemma 3 de 4 mil millones de parámetros: prioridad en calidad

Recomendamos gemma3:4b para explicaciones educativas, apoyo en programación y consultas técnicas en las que se tolere una respuesta más lenta.

LFM2 de 700 millones de parámetros: prioridad en rapidez

Recomendamos sam860/LFM2:700m para consultas breves, asistentes educativos sencillos e interacciones frecuentes. gemma2:2b permanece como alternativa de respaldo.

10. ¿Valió la pena ampliar la RAM de 8 a 32 GB?

La ampliación aportó capacidad para cargar modelos y trabajar con mayores contextos, pero todavía no podemos demostrar que toda esa memoria fuera indispensable para los modelos seleccionados. También cambiaron el almacenamiento y parte del entorno de software, de modo que no sería válido atribuir cualquier mejora solamente a la RAM. En inferencia sobre CPU importan el procesador, el ancho de banda de memoria, el tamaño del modelo y la configuración de ejecución.

11. Lo que aprendimos

Una computadora antigua puede ejecutar IA local, pero el modelo más grande no siempre es la mejor elección. La velocidad y la calidad deben medirse por separado; el tiempo total no sustituye a los tokens por segundo. Las evaluaciones automáticas necesitan verificaciones objetivas. Guardar respuestas, parámetros y resultados permite auditar sin repetir inferencias costosas. Finalmente, una inversión en hardware debe justificarse con mediciones comparables.

12. Próximo proyecto: iRoX-Bench Lite

Proponemos desarrollar iRoX-Bench Lite, una herramienta que ayude a estudiantes, docentes e instituciones a evaluar computadoras reutilizadas como servidores de IA. Queremos que en minutos u horas identifique modelos viables, memoria utilizada, velocidad, calidad aproximada y mejoras de hardware potencialmente justificadas.

El plan contempla un diagnóstico rápido de 15–30 minutos, una evaluación estándar de 60–120 minutos y pruebas ampliadas cuando sean necesarias. Son objetivos de diseño, no tiempos garantizados.

Conclusiones

Tras evaluar 22 modelos con 220 pruebas, encontramos dos opciones útiles para el servidor estudiado: gemma3:4b cuando importa la calidad y sam860/LFM2:700m cuando importa la rapidez. Más allá de estos resultados, el objetivo es crear un procedimiento sencillo que permita a otras personas evaluar equipos existentes antes de desecharlos o invertir en actualizaciones.

Antes de desechar una computadora, vale la pena investigar qué puede hacer con las herramientas actuales.

Referencias y recursos

  1. Sandria, J. C. (2026). Instalación de una IA generativa con Ubuntu y Ollama. Robótica Sandria.
  2. Instituto de Robótica de Xalapa (2026). Benchmark iRoX V0.8.7: resultados consolidados de 22 modelos. Documentación interna del proyecto.
  3. Ollama. Documentación oficial y API.
  4. ggml-org. llama.cpp.
  5. EleutherAI. Language Model Evaluation Harness.
  6. MLCommons. MLPerf Inference.
  7. Vaswani, A., et al. (2017). Attention Is All You Need. NeurIPS 30.
  8. ChatGTP. chatgpt.com.

Nota metodológica: Las puntuaciones corresponden a la evaluación operativa iRoX V0.8.7. Algunas calificaciones históricas no se han verificado exhaustivamente mediante revisión independiente. Los resultados describen el comportamiento observado en este servidor y no deben extrapolarse automáticamente a otros equipos o aplicaciones.

Instalación de una IA Generativa con Ubuntu y Ollama

Página de inicio de Open WebUi

Por: Julio C. Sandria R.

Introducción

En este artículo comparto la bitácora del proceso que realicé con la asistencia de Google Gemini para desplegar un entorno de inteligencia artificial generativa (IAG) local, privado y autohospedado. El sistema se instaló utilizando Ollama como motor de inferencia y Open WebUI como interfaz gráfica, ejecutándose sobre una computadora de escritorio antigua con Ubuntu Server 24.04 LTS, limitada a 8 GB de RAM, un procesador Intel Pentium CPU G4400 @ 3.30GHz y un disco duro mecánico de 372 GB.

La idea principal fue buscar alternativas para ejecutar de forma local una IA Generativa con la finalidad de reducir costos. Al utilizar herramientas comerciales de forma gratuita (como ChatGPT, Claude o DeepSeek), es común agotar los límites de uso o tokens disponibles, lo que obliga a pagar suscripciones mensuales o anuales para continuar.

Pregunta: ¿Qué es la inteligencia artificial generativa?

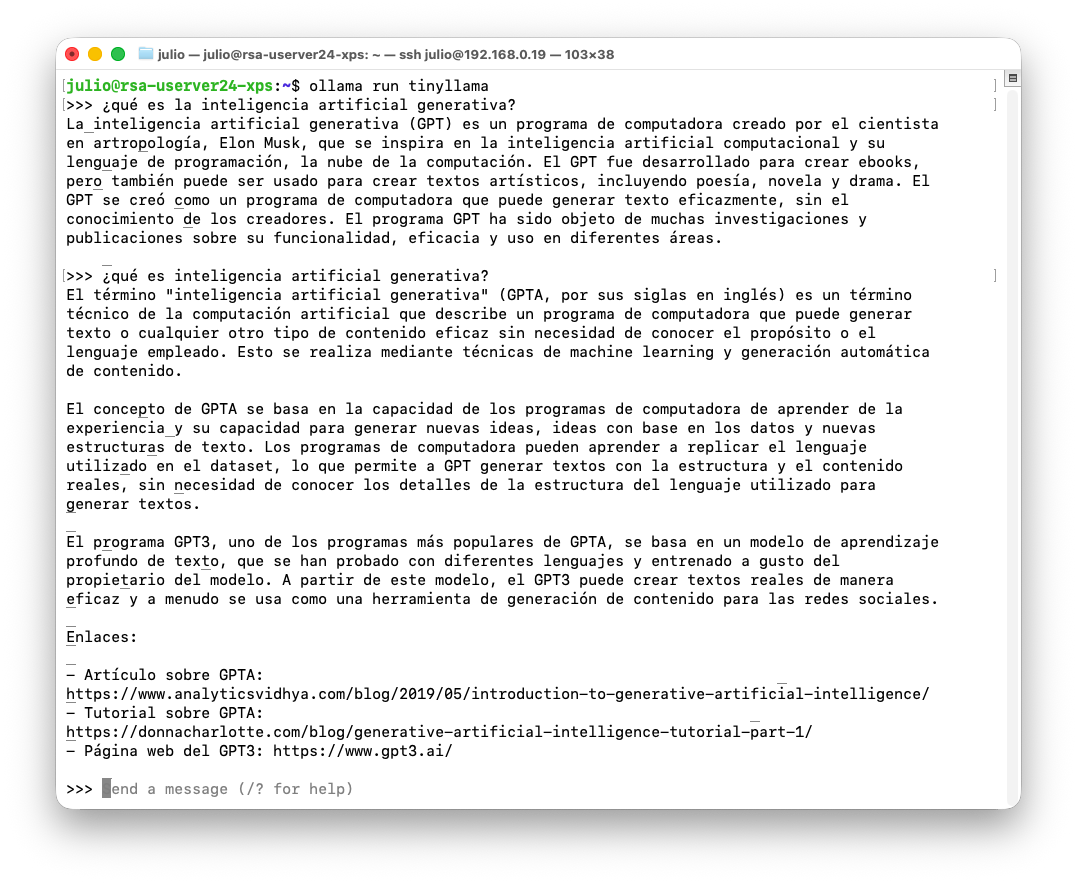
La interfaz de consola ejecutada en una terminal funciona con los tres modelos de lenguaje descargados, pero aquí se muestra solo con el modelo más pequeño (TinyLlama). Una vez iniciado Ollama, al responder por primera vez a la pregunta, tardó poco más de 3 minutos en comenzar a mostrar texto. La segunda vez que se hizo la misma consulta, empezó a responder a los 16 segundos. Esto ocurre porque en la primera ejecución el sistema debe cargar por completo el archivo del modelo en la memoria RAM. Por cierto, a la misma pregunta respondió de forma diferente, como se puede apreciar en la siguiente imagen.

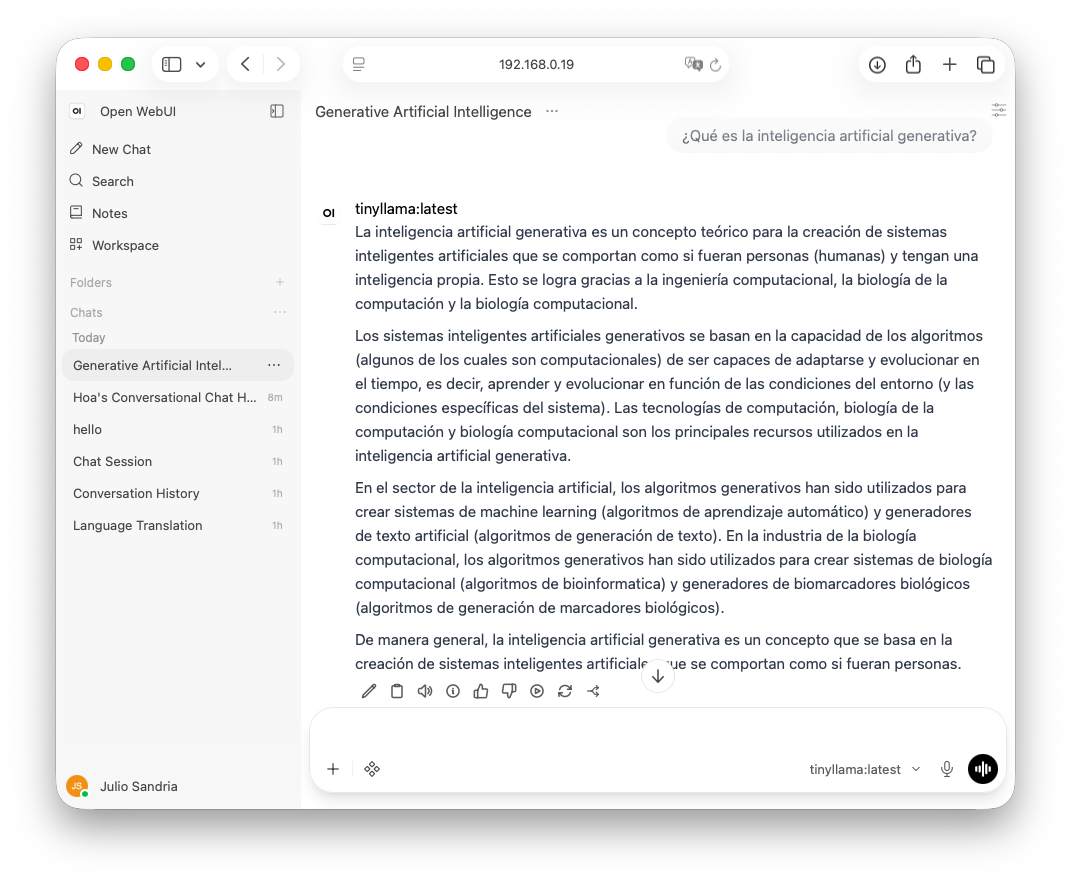
Por su parte, la interfaz web Open WebUI solo logró ejecutarse de forma estable con el modelo de lenguaje más pequeño. Los tiempos de respuesta variaron desde varios segundos hasta minutos para iniciar la redacción en español. A la misma pregunta realizada previamente en la terminal, ofreció una respuesta completamente diferente después de 5 minutos de procesamiento.

Durante este proceso se cambió el disco duro mecánico por una unidad de estado sólido (ssd), con lo cual se mejoró el tiempo de inicio de respuesta de Ollama a 1 ó 2 segundos. En la tabla siguiente se muestran los modelos probados y algunas de sus características. Un parámetro es una variable ajustable que define cómo va a actuar un sistema o qué resultado va a entregar. Esto nos da una idea de qué tan grande es el modelo de lenguaje, medido en billones de parámetros.

Modelo Parámetros Consumo / Características Principales Rendimiento en Hardware Limitado (8GB RAM)
TinyLlama 1.1B Modelo minimalista y ultraligero; diseñado para CPU, no soporta function calling nativo. Respuesta más rápida y estable; ideal para pruebas de concepto tras deshabilitar herramientas avanzadas.
Qwen 2.5 1.5B Arquitectura compacta optimizada para lógica y razonamiento en español. Rendimiento muy justo; excelente lógica pero requiere buena optimización del entorno.
Llama 3.2 3B Modelo equilibrado de Meta con gran capacidad de comprensión y generación general. Con el cambio a disco SSD, mejoró notablemente su velocidad de carga frente al disco mecánico anterior.

Reflexión final: Como resumen humano, utilizar una computadora antigua para correr una IAG de manera local es una experiencia de aprendizaje e implementación muy interesante, pero no es práctica para el uso cotidiano debido a los tiempos de espera. Para obtener un rendimiento fluido y respuestas ágiles, se requiere infraestructura más robusta: mayor cantidad de memoria RAM, un procesador más potente, el uso indispensable de unidades de estado sólido (SSD) en lugar de discos mecánicos, e idealmente una tarjeta gráfica dedicada con memoria VRAM.

Las líneas a continuación corresponden al resumen técnico generado por Gemini al finalizar toda la interacción de instalación y configuración:

Conceptos Clave

  • LLM (Large Language Model): Sistema de inteligencia artificial entrenado para comprender, generar y procesar lenguaje natural.
  • Ollama: Herramienta ligera y de código abierto diseñada para descargar, configurar y ejecutar modelos de lenguaje localmente en tu propia infraestructura.
  • Docker: Tecnología de virtualización basada en contenedores para empaquetar aplicaciones con todas sus dependencias de forma aislada y eficiente.

1. Actualización del Sistema

Antes de comenzar con la instalación de los servicios, es recomendable actualizar los paquetes del sistema operativo:

sudo apt update && sudo apt upgrade -y

2. Instalación y Configuración de Ollama

Ollama es el motor backend encargado de ejecutar los modelos de lenguaje localmente. Se instala mediante su script oficial:

curl -fsSL https://ollama.com/install.sh | sh

Para verificar que el servicio se encuentra activo y funcionando correctamente:

sudo systemctl status ollama

Con el siguiente comando puedes verificar que quedó instalado Ollama y se ejecuta con el modelo reducido TinyLlama (1.1B):

ollama run tinyllama

Toma en cuenta que la primera vez que usas un modelo, se descarga de internet a tu servidor y después se carga el modelo completo en la memoria RAM. Ante el prompt de ollama «>>>» escribe un saludo o una pregunta y contestará. Para salir de ollama usa el comando /bye.

Para instalar Qwen 2.5 (1.5B) usa el siguiente comando:

ollama run qwen2.5:1.5b

Con el siguiente comando ejecutas Ollama con el modelo Llama 3.2 (3B):

ollama run llama3.2:3b

Exponer Ollama a la red local: Por defecto, Ollama solo escucha en localhost. Para permitir conexiones desde otros equipos de la red, edita la configuración del servicio:

sudo SYSTEMD_EDITOR=nano sudo systemctl edit ollama.service

Añade las siguientes líneas dentro de la sección [Service]:

[Service]
Environment="OLLAMA_HOST=0.0.0.0:11434"

Guarda los cambios y reinicia el demonio:

sudo systemctl daemon-reload
sudo systemctl restart ollama

Permite el tráfico en el cortafuegos si es necesario:

sudo ufw allow 11434/tcp
sudo ufw enable
sudo ufw reload

Una vez habilitado el cortafuegos puedes abrir en un navegador la dirección http://IP_SERVIDOR:11434 reemplazando IP_SERVIDOR por la dirección IP de tu Servidor, y deberás ver la respuesta en una sola línea: Ollama is running. Con esto verificas que Ollama ya escucha peticiones como servidor web.

3. Instalación de Docker

Docker permite ejecutar Open WebUI en un contenedor aislado optimizando el uso de recursos:

sudo apt update
sudo apt install docker.io docker-compose-v2 -y
sudo systemctl enable --now docker

4. Despliegue de Open WebUI

Open WebUI provee la interfaz gráfica web accesible desde cualquier navegador, emulando una experiencia similar a ChatGPT:

sudo docker run -d -p 3000:8080 --add-host=host.docker.internal:host-gateway -v open-webui:/app/backend/data --name open-webui --restart always ghcr.io/open-webui/open-webui:main

Una vez completado, puedes acceder desde tu navegador mediante:

http://IP_DE_TU_SERVIDOR:3000

Cuando se abra la página principal de Open WebIU oprime el botón Get started, llena el formulario con tu nombre, correo y contraseña que son para crear el usuario administrador y listo, ya puedes usar tu propio ChatBot en tu propio servidor.

5. Modelos recomendados y solución para modelos ultraligeros

Debido a la limitación de memoria RAM en servidores de 8 GB, se evaluó el comportamiento de distintos modelos:

  • Llama 3.2 (3B) y Qwen 2.5 (1.5B): Al probar modelos de mayor tamaño en la interfaz web, se presentaron saturaciones de procesamiento y bloqueos de ejecución en el hardware disponible.
  • TinyLlama (1.1B): Se implementó como modelo ultraligero de prueba (ollama run tinyllama), logrando una respuesta rápida y fluida directamente en el motor.

Ajuste crítico de compatibilidad en Open WebUI: Para lograr que el modelo ultraligero respondiera correctamente a través de la interfaz web sin arrojar errores internos, fue necesario acceder a la configuración del modelo dentro de Open WebUI y desmarcar la opción «Builtin Tool» en el panel de capacidades. Esto evita que la interfaz intente forzar llamadas a funciones o herramientas no soportadas por la arquitectura minimalista de TinyLlama.

Referencias y Enlaces de Interés

  1. Ollama Documentation and Official Repository. Disponible en: https://ollama.com
  2. Open WebUI Official Documentation. Disponible en: https://github.com/open-webui/open-webui